SEO vs. GEO: waarom GEO niet bestaat zonder goede SEO
Elke week lanceert weer een bureau een GEO-dienst. Maar AI-antwoorden komen uit hetzelfde web dat SEO al twintig jaar bouwt. GEO is de output van goede SEO, geen nieuwe discipline.
- GEO is geen aparte discipline: AI-antwoorden zijn gebouwd op standaard search retrieval, dus SEO bepaalt wat gevonden wordt.
- Prompt tracking meet één synthetische run, geen echte gebruikers met eigen intentie, context en platform.
- Zichtbaarheid heeft zes toestanden, van toegankelijk tot gekozen. Geciteerd worden is niet hetzelfde als aanbevolen worden, en terechte uitsluiting is een win.
- Repareer eerst kern-SEO en meting, bouw daarna pagina’s voor de onderkant van de funnel, digital PR en agentic endpoints.
Elke week kondigt weer een bureau een GEO-dienst aan. Ze voegen nieuwe dashboards, budgetposten en functietitels toe, en ze beloven allemaal hetzelfde: zichtbaarheid in AI-antwoorden.
Ik blijf terugkomen op een vraag die niemand in die salesgesprekken beantwoordt. Waar denkt u dat de AI zijn antwoorden vandaan haalt?
Niet uit een aparte index die alleen voor chatbots is gebouwd. Generatieve engines putten uit hetzelfde web dat SEO al twintig jaar crawlbaar, gestructureerd en geloofwaardig maakt. Dus als iemand uw GEO verkoopt als een nieuwe discipline, verkoopt hij u een spiegelbeeld en vraagt hij u het object te negeren.
Een spiegelbeeld kunt u niet oppoetsen. U kunt alleen veranderen wat er voor de spiegel staat.
Mijn stelling is dus simpel: GEO is geen discipline. GEO is het antwoord dat AI genereert uit de downstream-output van uw goede SEO. Dat betekent crawlbare architectuur, geloofwaardigheid van bronnen, entity-building en vertrouwen van derden. Het AI-antwoord is waar dat werk zichtbaar wordt, niet waar het gebeurt.
Het verkeersdebat is echt, maar het is de verkeerde strijd
Er zijn hier twee kampen, en allebei hebben ze een punt.
Marie Haynes bekeek 12 maanden aan GA4-data van 100 websites en meer dan 145 miljoen sessies. ChatGPT zorgde voor 0,62% van het aantal sessies van Google Organic, en met alle andere LLM’s erbij steeg dat maar naar 0,73%. ChatGPT-bezoekers converteerden wel beter: 13,8% tegenover 3,02%. Maar volume wint. Google Organic leverde nog steeds 27 keer meer conversies op dan alle LLM’s samen. En de groei van ChatGPT-verwijzingen stagneerde rond augustus 2025 en begon daarna te dalen.
Mike King beweert het omgekeerde: AI-zoeken beoordelen op klikken is als een Super Bowl-reclame beoordelen op de click-through rate.
Sterker nog, ik vind Mikes argument zo goed dat ik zijn vergelijkingen leen, want ze zetten AI-zoeken precies waar het hoort:
“Een AI-antwoord is earned media, geschreven door een machine.”
en
“Niemand heeft ooit een billboard toegeschreven. Niemand schrijft een tv-spot toe, een gesponsorde podcast, een stadionnaam of een celebrity die op de rode loper een product vasthoudt.”
AI-zoeken is een merkkanaal voor vertrouwen en positionering op het moment dat mensen opties vergelijken. Met honderden miljoenen tot miljarden gebruikers verspreid over ChatGPT, AI Overviews, AI Mode en Gemini telt aanwezigheid ook zonder de klik.
Op het eerste gezicht lijkt dit een discussie over klikken versus merk. Dat is het volgens mij niet. Het is een discussie over meten. Beide kampen zeggen uw hetzelfde: de manier waarop we AI-zichtbaarheid nu meten, deugt niet.
Prompt tracking meet het verkeerde
Zo, dat moest er even uit. Zucht… De meeste GEO-dashboards nemen de logica van rank tracking en passen die toe op een systeem dat niet rankt. Dat is de kernfout.
In klassiek zoeken geeft een zoekwoord ongeveer dezelfde resultaten voor iedereen. In generatief zoeken is de prompt maar een deel van de input. ChatGPT gebruikt ook geheugen, context, platformgedrag en locatie, en herschrijft daarna de echte zoekopdracht voordat het antwoord geeft.
Neem één prompt: “Wie is de beste basketballer ooit?”
- Gebruiker A vindt kampioenschappen en nalatenschap belangrijk. Die krijgt Jordan.
- Gebruiker B waardeert lange carrières en all-round cijfers. Die krijgt LeBron.
- En ik vind mentaliteit belangrijk, en dat iemand deel is van mijn basketbalreis. Dus ik zeg Kobe Bryant.
Alle drie de antwoorden kloppen, en geen ervan is een ranking. Een promptmonitor speelt alleen de tekststring opnieuw af. Hij speelt de persoon niet opnieuw af.
Leveranciers meten dus de kans om geciteerd te worden bij een prompt:
P(citation | prompt)
Maar waar het echt om gaat is de kans om geciteerd te worden bij de intentie en context van de gebruiker, op een platform, op een bepaald moment:
P(citation | intent, context, platform, time)
Dat is een andere vergelijking, dus u hebt een ander meetinstrument nodig.
En het wordt erger. De query fan-out van Google splitst één vraag op in veel synthetische subzoekopdrachten om een antwoord op te bouwen. Die subzoekopdrachten zijn retrieval-bewerkingen, geen menselijke vraag. Precies daar gaat de rapportage van sommige bureaus de mist in. Genereer honderden machinale subzoekopdrachten, verschijn in meer ervan, en u hebt een slide met “AI-zichtbaarheid gestegen van 18% naar 64%.” U hebt gemeten hoe het systeem zich gedraagt, niet wie u daadwerkelijk hebt bereikt.
Het onderzoek wijst dezelfde kant op. Een preprint van Mahe Chen en Nick Koudas analyseerde zo’n 158.000 ChatGPT-antwoorden en 468.000 citaties. Search retrieval verklaarde ongeveer 32% van de variantie in het aantal citaties. On-page “GEO”-kenmerken verklaarden 2,8%.
Het probleem is dus niet de opmaak. Het is retrieval. AI citeert u omdat search u heeft gevonden en u past bij de context, niet omdat u de pagina hebt opgetut voor een robot.
Zelfs de platforms zeggen dit hardop. Bing Webmaster Tools stelt dat AI-citaties geen rankings zijn en geen signaal van autoriteit, en dat de data een steekproef is.
Wat elke methode echt bewijst
| Methode | Wat het bewijst | Hoeveel u het kunt vertrouwen |
|---|---|---|
| Vaste promptmonitoring | Uw kwam voor in één gesamplede synthetische run | Laag: grote variantie, geen context, open voor cherry-picked prompts |
| Contextgestratificeerde tests | Hoe vaak u voorkomt bij vastgestelde persona’s | Matig: goed voor diagnose, zegt niets over echt bereik |
| Platform-native data (GSC, Bing WMT) | Waargenomen blootstelling aan echte gebruikers | Sterker, maar gesampled, en citaties ≠ ranking |
| AI-verwijzingsverkeer + conversies | Echte sessies en omzet | Sterk voor getrackte bezoeken, blind voor zero-click-invloed |
| Gecontroleerde voor/na-tests | Mogelijke incrementele impact | Hangt af van de opzet; ruis rond updates en seizoenen |
Zichtbaarheid is niet één ding. Er zijn zes toestanden.
“Zijn of niet zijn.” “Zichtbaar zijn of onzichtbaar zijn.” Hoe mooi dat ook klinkt, die framing moet weg.
Waar u echt naar kijkt, is een keten:
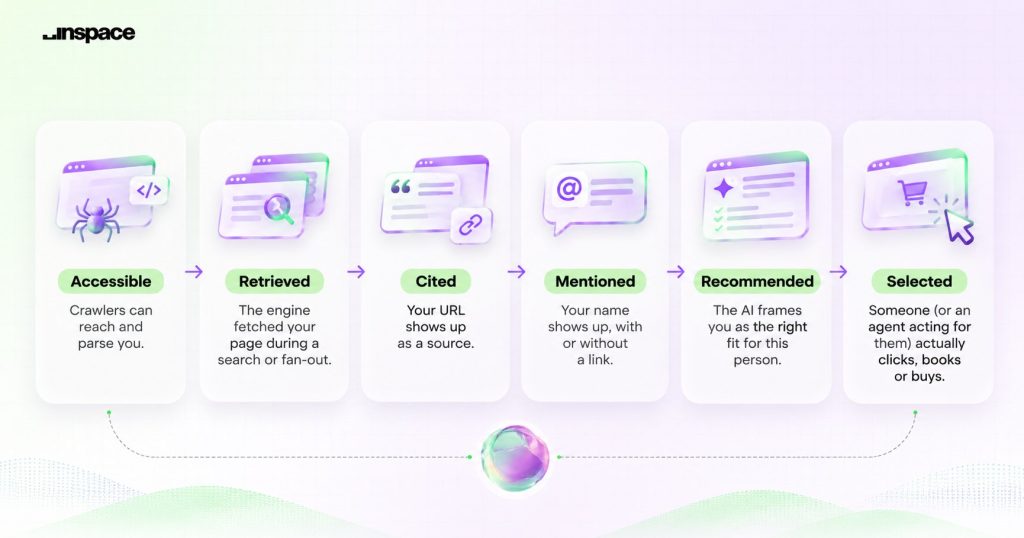
Toegankelijk → Opgehaald → Geciteerd → Genoemd → Aanbevolen → Gekozen
- Toegankelijk: crawlers kunnen u bereiken en uitlezen.
- Opgehaald: de engine heeft uw pagina binnengehaald tijdens een zoekopdracht of fan-out.
- Geciteerd: uw URL verschijnt als bron.
- Genoemd: uw naam verschijnt, met of zonder link.
- Aanbevolen: de AI presenteert u als de juiste keuze voor deze persoon.
- Gekozen: iemand (of een agent namens die persoon) klikt, boekt of koopt echt.
De meeste GEO-rapportage stopt bij “geciteerd” en noemt dat een win. Maar geciteerd worden is niet hetzelfde als aanbevolen worden.
Stel u voor dat iemand vraagt: “Welke mountainbike is het beste voor een fietser van 125 kg op asfalt en gravel?” Winkel A schreef een koopgids met gegevens over het maximale gewicht, dus die wordt geciteerd. Winkel B verkoopt een fiets die precies voor die belasting en dat terrein is gebouwd, dus die wordt aanbevolen.
A kreeg de citatie. B kreeg de klant.
Terecht uitgesloten worden is een win
Hier kijken de meeste dashboards naar het verkeerde.
Neem een hogeschool die alleen voltijd marketingopleidingen op de campus aanbiedt. Drie mensen stellen een vraag:
- Een scholier die een vierjarige voltijdopleiding wil
- Een professional die 40 uur werkt en avondlessen nodig heeft
- Een carrièreswitcher die een versneld certificaat zoekt
Als de AI deze school aanbeveelt aan de tweede of derde persoon, is dat geen zichtbaarheid. Het is een slechte lead, een slechte ervaring en een deuk in het vertrouwen. Als de AI de school voor die twee weglaat, noemt het dashboard dat “verloren zichtbaarheid”. Dat is het niet. Het is het systeem dat werkt.
De metric die u moet volgen is dus niet hoe vaak u erin zit. Het is of u erin zit op de juiste plekken:
Contextual Recommendation Accuracy (contextuele aanbevelingsnauwkeurigheid) = (passende aanbevelingen + terechte uitsluitingen) ÷ totaal aantal geëvalueerde scenario’s
Daarmee verschuift de vraag van “zitten we in het antwoord?” naar “zitten we in de juiste antwoorden, en buiten de verkeerde?”
Waarom SEO de retrieval-laag nog steeds in handen heeft
Generatieve engines lezen het web niet vanaf nul. Ze draaien bovenop zoekinfrastructuur en RAG. Google’s eigen documentatie zegt dat de AI-functies draaien op standaard Search-systemen.
Dat maakt de meeste “GEO-tactieken” een afleiding:
- llms.txt: verkocht als essentieel, maar geen enkele grote zoekmachine eist het voor generatieve zichtbaarheid. Normaal crawlen bepaalt nog steeds wat erin komt.
- “AI-schema”: bestaat niet als vereiste. Standaard schema.org bevat de entity-informatie al.
- Micro-chunking voor vectoren: pagina’s hakken in losse snippets geeft u geen retrieval-voordeel ten opzichte van een goed gestructureerde pagina, en de pagina leest er slechter van.
- Schrijven voor machines: uw stem platslaan tot robotachtige feitenlijstjes werkt tegen systemen die zijn gebouwd om mensen te belonen die tevreden zijn met wat ze lezen.
| Kern-SEO | De “GEO”-versie | Wat er echt gebeurt |
|---|---|---|
| Crawlbaarheid & indexatie | llms.txt, AI-specifiek crawlen | Standaardindexen voeden RAG |
| Gestructureerde data | Eigen “AI-schema” | Schema.org dekt het al |
| Topical authority | Micro-chunking | Uitgebreide expertpagina’s worden opgehaald |
| Digital PR & vermeldingen | Prompt-stuffing, LLM-seeding | Modellen halen consensus uit bronnen van derden |
De tactiek is het symptoom. De infrastructuur is de oorzaak.
Off-page is waar aanbevelingen worden beslist
PromptWatch-data over geciteerde assettypes laat zien dat listicles en roundups goed zijn voor 18,7% van de citaties, landingspagina’s voor 15,2% en productdetailpagina’s voor 14,0%.
Maar hier zit een addertje, en het is belangrijk. Als een merk een eigen “Top 10” publiceert en zichzelf op nummer 1 zet, lijken AI-systemen daar doorheen te prikken. Lily Ray ontdekte dat in de AI Overviews van Google deze zelfpromotionele listicles vaak als bron werden geciteerd, terwijl de AI toch een ander merk aanbeveelde. Het systeem pakt de lijst en laat de bevooroordeelde host weg.
Het is dus niet genoeg om de lijst te publiceren. U moet op de lijst van een ander staan. Dat betekent digital PR, redactionele aandacht, reviewplatforms, Reddit en community-threads: de plekken die niet van u zijn, waar modellen checken wat mensen echt vinden.
De volgende laag: search als agent manager
Als u verder uitzoomt, wordt de verschuiving groter dan citaties.
De top van Google, Sundar Pichai en Demis Hassabis, beschrijft search als iets dat verschuift van een linkindex naar een agent manager: iets dat taken coördineert, workflows uitvoert en transacties afrondt voor de gebruiker.
Dat verandert het hele plaatje. Het is niet langer “gebruiker zoekt → klikt → koopt.” Het is “gebruiker geeft intentie en randvoorwaarden aan → agent vergelijkt, onderhandelt en doet de transactie.”
Vier lagen om in de gaten te houden:
- Google’s Universal Cart. Afrekenen bij meerdere retailers binnen Google Wallet, met bijhouden van voorraad, prijswijzigingen en acties. Wat u moet doen: behandel uw Merchant Center-feed als een product, niet als een karwei. Nauwkeurigheid in realtime, schone prijsmarkup, niets verouderds.
- Universal Commerce Protocol (UCP). Een open standaard, samen ontwikkeld door Google en Shopify, waarmee agents producten ontdekken, vergelijken en afrekenen terwijl u de merchant of record blijft. Wat u moet doen: voeg agentic endpoints zoals
/.well-known/ucptoe aan uw technische audits. - WebMCP. Stelt de interactieve tools van een site (calculators, planners, troubleshooters) rechtstreeks beschikbaar aan agents, zodat ze uw functies aanroepen in plaats van uw tekst te scrapen. Wat u moet doen: som uw beslistools op en maak ze aanroepbaar.
- Slimme brillen en multimodaal zoeken. Zoeken verhuist van het scherm naar de kamer. “Kijk naar dit apparaat, stel vast waar het geluid vandaan komt, bestel het onderdeel.” Wat u moet doen: koppel scenario’s van echt probleem → oplossing aan gestructureerde data en visuele assets.
En dit is het stuk waar de meeste organisaties over struikelen. Technische SEO, feedbeheer, development en PR zitten meestal in aparte kamers. In een agentic wereld zijn ze één pipeline. De agent kan uw product niet afrekenen als dev het endpoint niet beschikbaar heeft gemaakt, of de feed de verkeerde prijs toont, of PR nooit het vertrouwen heeft opgebouwd waardoor u op de shortlist kwam.
Dit is geen kanaalprobleem meer. Het is een organogramprobleem.
Wie moet er nu echt investeren, en wie moet eerst de kelder opruimen
Niet elk bedrijf hoeft hier nu achteraan.
Investeer nu als:
- Uw klantreis complex is en veel overweging vraagt: onderwijs, B2B-software, financiën, zorg, technische apparatuur.
- Een fout AI-antwoord over uw specificaties echte operationele, financiële of juridische schade veroorzaakt.
- Uw SEO-fundament, sitearchitectuur en conversietracking al werken.
Repareer eerst het fundament als:
- U nog onopgeloste technische SEO-, indexatie- of mobiele problemen hebt.
- U geen conversies trackt. In de dataset van Haynes deden 45 van de 100 sites dat niet, wat betekent dat ze niet eens konden meten wat ze willen verbeteren.
- U impulsproducten verkoopt waar weinig over nagedacht wordt en die niemand via een AI onderzoekt.
De volgorde
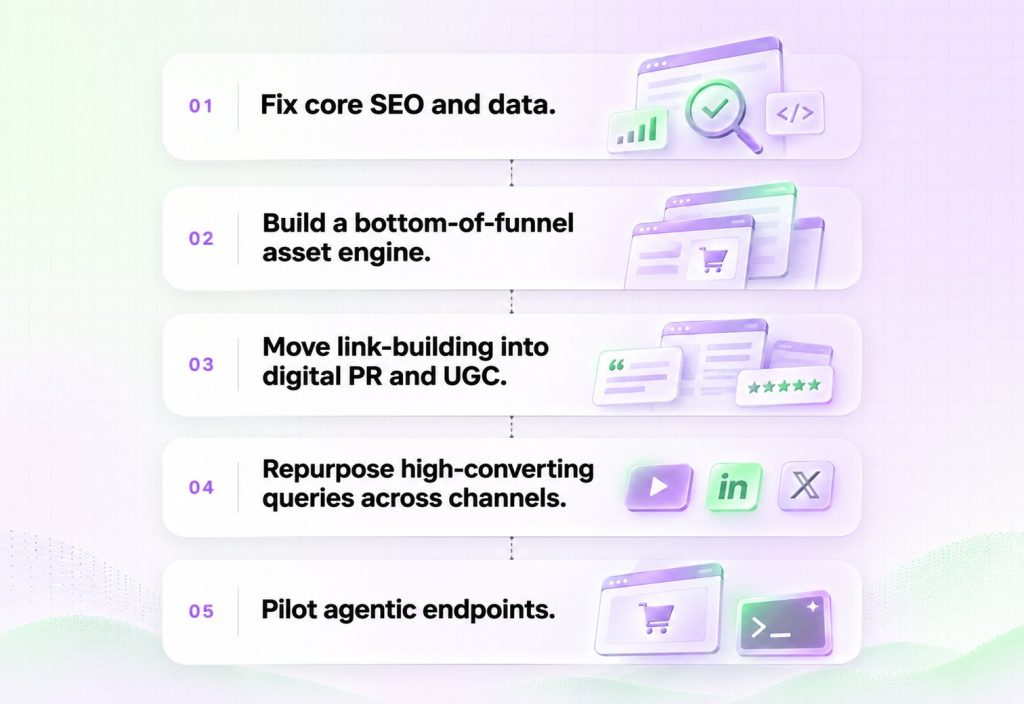
- Repareer kern-SEO en data. Crawlfouten, entity-schema, GA4-conversies. Zonder meting is alles hierna gokwerk.
- Bouw een asset-engine voor de onderkant van de funnel. Gestructureerde landingspagina’s en productpagina’s. Samen vormden ze bijna 30% van de citaties in de PromptWatch-data.
- Verplaats linkbuilding naar digital PR en UGC. Kom in roundups van derden, redactionele stukken en reviewhubs. Zorg voor echt sentiment op de plekken waar modellen lezen.
- Hergebruik converterende zoekopdrachten in andere kanalen. Korte video, LinkedIn, X. Niet voor bereikstheater, maar om entity-dichtheid op te bouwen over het hele web.
- Test agentic endpoints. Doe kleine experimenten per kwartaal: Merchant Center voor geschiktheid voor Universal Cart, WebMCP op één interactieve tool.
Wat verandert er dan echt
Niemand foppt een LLM zodat die hem aanbeveelt. Niet met llms.txt, niet met “AI-schema”, niet met in stukjes gehakte robottekst.
Vergelijk AI-zichtbaarheid met een billboard: het is meer branding dan performance, en het levert in de eerste plaats geen verkeer op.
Wat verandert, is de vraag die u stelt. Niet “hoe komen we voor in AI?” maar “is ons merk waar, vindbaar en betrouwbaar genoeg dat elk systeem, mens of machine, ons kiest voor de juiste persoon en ons weglaat voor de verkeerde?”
Dat is geen nieuwe discipline. Het is SEO, eindelijk gemeten aan de juiste uitkomst. We noemen het alleen GEO.
Bronnen
- ChatGPT sends less than 1% of Google’s traffic (Search Engine Land)
- ChatGPT sends less than 1% of Google’s traffic (MarTech)
- Haynes study coverage, incl. 45/100 sites not tracking conversions (info-lux)
- Universal Commerce Protocol (Shopify)
- Self-Promotional Content Works, Until It Backfires (Ahrefs)
Gregory spit voor InSpace-klanten door SERP’s en Search Console-data, en deelt wat echt verschil maakt.