SEO vs GEO : pourquoi le GEO n’existe pas sans un bon SEO
Chaque semaine, une nouvelle agence lance un service GEO. Mais les réponses de l’IA viennent du même web que le SEO construit depuis vingt ans. Le GEO est le résultat d’un bon SEO, pas une nouvelle discipline.
- Le GEO n’est pas une discipline à part : les réponses de l’IA reposent sur la récupération de recherche standard, donc le SEO décide de ce qui est trouvé.
- Le suivi de prompts mesure une seule exécution synthétique, pas de vrais utilisateurs avec leur propre intention, contexte et plateforme.
- La visibilité a six états, d’accessible à sélectionné. Être cité, ce n’est pas être recommandé, et une exclusion correcte est une victoire.
- Corrigez d’abord le SEO de base et la mesure, puis construisez des pages de bas de funnel, de la digital PR et des endpoints agentiques.
Chaque semaine, une nouvelle agence annonce un service GEO. Elles ajoutent des tableaux de bord, des lignes de budget et des intitulés de poste, et toutes promettent la même chose : de la visibilité dans les réponses de l’IA.
Ce qui me revient sans cesse, c’est une question à laquelle personne ne répond lors de ces appels commerciaux. D’après vous, d’où l’IA tire-t-elle ses réponses ?
Pas d’un index séparé, construit uniquement pour les chatbots. Les moteurs génératifs puisent dans le même web que le SEO rend explorable, structuré et crédible depuis vingt ans. Donc quand quelqu’un vous vend le GEO comme une nouvelle discipline, il vous vend un reflet et vous demande d’ignorer l’objet.
On ne peut pas polir un reflet. On peut seulement changer ce qui se trouve devant le miroir.
Ma thèse est donc simple : le GEO n’est pas une discipline. Le GEO, c’est la réponse que l’IA génère à partir de ce que produit en aval votre bon SEO. Autrement dit : une architecture explorable, la crédibilité des sources, la construction d’entités et la confiance de tiers. La réponse de l’IA est l’endroit où ce travail se voit, pas l’endroit où il se fait.
Le débat sur le trafic est réel, mais c’est le mauvais combat
Il y a deux camps, et les deux ont un point.
Marie Haynes a analysé 12 mois de données GA4 sur 100 sites web et plus de 145 millions de sessions. ChatGPT a généré 0,62 % des sessions de Google Organic, et en ajoutant tous les autres LLM, on n’est monté qu’à 0,73 %. Les visiteurs venus de ChatGPT convertissaient mieux, 13,8 % contre 3,02 %. Mais c’est le volume qui l’emporte. Google Organic a quand même généré 27 fois plus de conversions que tous les LLM réunis. Et la croissance des visites référées par ChatGPT a calé vers août 2025, avant de commencer à reculer.
Mike King défend l’autre position : juger la recherche IA sur les clics, c’est comme juger une publicité du Super Bowl sur son taux de clic.
J’aime tellement l’argument de Mike que je vais lui emprunter ses analogies, parce qu’elles placent la recherche IA exactement là où elle doit être :
« Une réponse d’IA, c’est de l’earned media composé par une machine. »
et
« Personne n’a jamais attribué un panneau publicitaire. Personne n’attribue un spot télévisé, un podcast sponsorisé, un contrat de naming de stade ou une célébrité qui tient un produit sur un tapis rouge. »
La recherche IA est un canal de marque, un canal de confiance et de positionnement au moment où les gens comparent les options. Avec des centaines de millions, voire des milliards d’utilisateurs sur ChatGPT, AI Overviews, AI Mode et Gemini, la présence compte même sans le clic.
Au premier abord, cela ressemble à un débat clics contre marque. Je ne le crois pas. C’est un débat sur la mesure. Les deux camps vous disent la même chose : la façon dont nous mesurons aujourd’hui la visibilité dans l’IA est défaillante.
Le suivi de prompts mesure la mauvaise chose
Voilà ! Il fallait que ça sorte. Soupir… La plupart des tableaux de bord GEO reprennent la logique du suivi de positions et l’appliquent à un système qui ne classe pas. C’est l’erreur de fond.
Dans la recherche classique, un mot-clé renvoie à peu près les mêmes résultats à tout le monde. Dans la recherche générative, le prompt n’est qu’une partie de l’entrée. ChatGPT utilise aussi la mémoire, le contexte, le comportement de la plateforme et la localisation, puis réécrit la vraie requête de recherche avant de répondre.
Prenons un prompt : « Qui est le meilleur basketteur de tous les temps ? »
- L’utilisateur A valorise les titres et l’héritage. Il obtient Jordan.
- L’utilisateur B valorise la longévité et les statistiques globales. Il obtient LeBron.
- Et moi, je valorise le mental et le fait d’avoir fait partie de mon parcours de basketteur. Donc je dirais Kobe Bryant.
Les trois réponses sont correctes, et aucune n’est un classement. Un outil de suivi de prompts ne rejoue que la chaîne de texte. Il ne rejoue pas la personne.
Les éditeurs mesurent donc la probabilité d’être cité pour un prompt :
P(citation | prompt)
Mais ce qui compte vraiment, c’est la probabilité d’être cité pour l’intention et le contexte de l’utilisateur, sur une plateforme, à un moment donné :
P(citation | intent, context, platform, time)
C’est une autre équation, elle demande donc un autre instrument.
Et ça empire. Le query fan-out de Google découpe une question en de nombreuses sous-requêtes synthétiques pour construire une réponse. Ces sous-requêtes sont des opérations de récupération, pas de la demande humaine. C’est exactement là que dérapent certains rapports d’agences. On génère des centaines de sous-requêtes machine, on apparaît dans davantage d’entre elles, et on obtient une slide qui annonce « visibilité IA passée de 18 % à 64 % ». Vous avez mesuré le comportement du système, pas les personnes que vous avez réellement touchées.
La recherche va dans le même sens. Une prépublication de Mahe Chen et Nick Koudas a analysé environ 158 000 réponses de ChatGPT et 468 000 citations. La récupération par la recherche expliquait environ 32 % de la variance du nombre de citations. Les caractéristiques « GEO » sur la page en expliquaient 2,8 %.
Le problème n’est donc pas la mise en forme. C’est la récupération. L’IA vous cite parce que la recherche vous a trouvé et que vous correspondez au contexte, pas parce que vous avez habillé la page pour un robot.
Même les plateformes le disent clairement. Bing Webmaster Tools indique que les citations de l’IA ne sont pas des classements ni un signal d’autorité, et que les données sont échantillonnées.
Ce que chaque méthode prouve réellement
| Méthode | Ce qu’elle prouve | Jusqu’où lui faire confiance |
|---|---|---|
| Suivi de prompts fixes | Vous êtes apparu dans une exécution synthétique échantillonnée | Faible : forte variance, aucun contexte, ouvert aux prompts choisis sur mesure |
| Tests stratifiés par contexte | La fréquence à laquelle vous apparaissez selon des personas définis | Modérée : utile pour le diagnostic, ne dit rien de la portée réelle |
| Données natives des plateformes (GSC, Bing WMT) | Une exposition observée auprès d’utilisateurs réels | Plus solide, mais échantillonnée, et citations ≠ classement |
| Trafic référé par l’IA + conversions | Des sessions et un chiffre d’affaires réels | Solide pour les visites suivies, aveugle à l’influence sans clic |
| Tests contrôlés avant/après | Un impact incrémental possible | Dépend de la conception ; bruité autour des mises à jour et de la saisonnalité |
La visibilité n’est pas une seule chose. Elle a six états.
« Être ou ne pas être. » « Être visible ou être invisible. » Aussi bien que ça sonne, il faut abandonner ce cadrage.
Ce que vous avez réellement sous les yeux, c’est une chaîne :
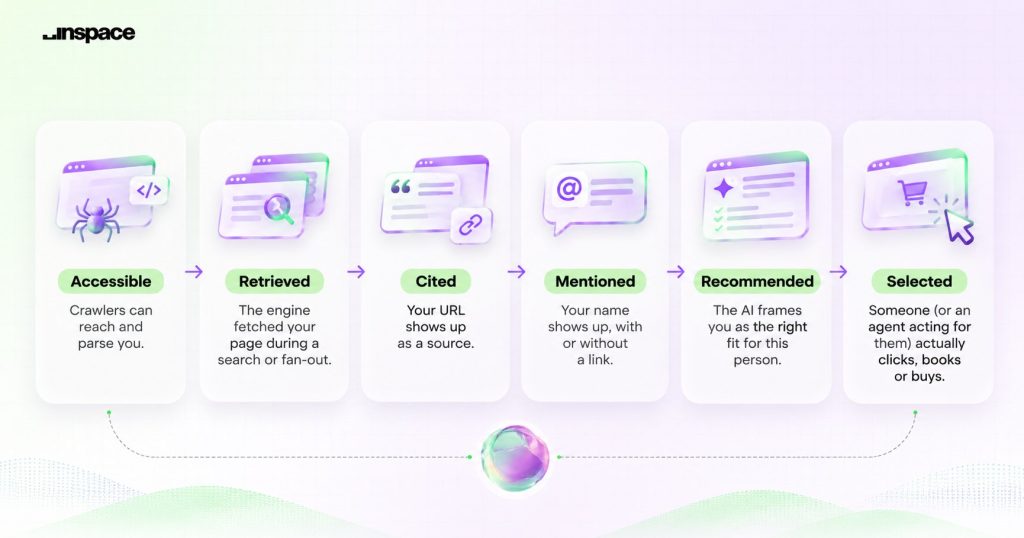
Accessible → Récupéré → Cité → Mentionné → Recommandé → Sélectionné
- Accessible : les crawlers peuvent vous atteindre et vous analyser.
- Récupéré : le moteur a récupéré votre page lors d’une recherche ou d’un fan-out.
- Cité : votre URL apparaît comme source.
- Mentionné : votre nom apparaît, avec ou sans lien.
- Recommandé : l’IA vous présente comme le bon choix pour cette personne.
- Sélectionné : quelqu’un (ou un agent qui agit pour lui) clique, réserve ou achète réellement.
La plupart des rapports GEO s’arrêtent à « cité » et appellent ça une victoire. Mais être cité, ce n’est pas être recommandé.
Imaginez quelqu’un qui demande : « Quel VTT convient le mieux à un cycliste de 125 kg, sur asphalte et sur gravier ? » Le détaillant A a rédigé un guide d’achat avec les données de charge maximale, il est donc cité. Le détaillant B vend un vélo conçu précisément pour cette charge et ce terrain, il est donc recommandé.
A a eu la citation. B a eu le client.
Une exclusion correcte est une victoire
C’est ici que la plupart des tableaux de bord regardent au mauvais endroit.
Prenons une haute école qui ne propose que des programmes de marketing à temps plein, sur le campus. Trois personnes posent la question :
- Un jeune diplômé du secondaire qui veut un diplôme de quatre ans à temps plein
- Un professionnel qui travaille 40 heures par semaine et a besoin de cours du soir
- Une personne en reconversion qui cherche un certificat accéléré
Si l’IA recommande cette école à la deuxième ou à la troisième personne, ce n’est pas de la visibilité. C’est un mauvais lead, une mauvaise expérience et une entaille dans la confiance. Si l’IA écarte l’école pour ces deux personnes, le tableau de bord parle de « visibilité perdue ». Ce n’est pas le cas. C’est le système qui fonctionne.
La métrique à suivre n’est donc pas la fréquence à laquelle vous êtes inclus. C’est le fait d’être inclus aux bons endroits :
Contextual Recommendation Accuracy (précision contextuelle des recommandations) = (recommandations appropriées + exclusions correctes) ÷ nombre total de scénarios évalués
Cela fait passer la question de « sommes-nous dans la réponse ? » à « sommes-nous dans les bonnes réponses, et absents des mauvaises ? »
Pourquoi le SEO reste maître de la couche de récupération
Les moteurs génératifs ne lisent pas le web à partir de zéro. Ils reposent sur l’infrastructure de recherche et sur le RAG. La documentation de Google indique elle-même que ses fonctionnalités d’IA s’appuient sur les systèmes standard de Search.
Ce qui fait de la plupart des « tactiques GEO » une distraction :
- llms.txt : vendu comme essentiel, mais aucun grand moteur de recherche ne l’exige pour la visibilité générative. C’est toujours l’exploration normale qui décide de ce qui entre.
- « Schema IA » : n’existe pas comme exigence. Le schema.org standard porte déjà les informations sur les entités.
- Micro-découpage pour les vecteurs : découper les pages en extraits déconnectés ne vous donne aucun avantage de récupération sur une page bien structurée, et rend la page pénible à lire.
- Écrire pour les machines : aplatir votre voix en listes de faits robotiques va à l’encontre de systèmes conçus pour récompenser les gens qui sont satisfaits de ce qu’ils lisent.
| SEO de base | La version « GEO » | Ce qui se passe réellement |
|---|---|---|
| Explorabilité & indexation | llms.txt, exploration spécifique à l’IA | Les index standard alimentent le RAG |
| Données structurées | « Schema IA » propriétaire | Schema.org couvre déjà ce besoin |
| Autorité thématique | Micro-découpage | Les pages d’experts complètes sont récupérées |
| Digital PR & mentions | Prompt-stuffing, LLM seeding | Les modèles synthétisent un consensus à partir de tiers |
La tactique est le symptôme. L’infrastructure est la cause.
C’est hors de la page que se décident les recommandations
Les données de PromptWatch sur les types de contenus cités placent les listicles et les comparatifs à 18,7 % des citations, les landing pages à 15,2 % et les fiches produit à 14,0 %.
Mais voici le hic, et il compte. Quand une marque publie son propre « Top 10 » et se place en première position, les systèmes d’IA semblent s’en rendre compte. Lily Ray a constaté que, dans les AI Overviews de Google, ces listicles auto-promotionnels étaient souvent cités comme source alors que l’IA recommandait quand même une autre marque. Le système prend la liste et laisse de côté l’hôte partial.
Publier la liste ne suffit donc pas. Il faut figurer dans la liste de quelqu’un d’autre. Cela passe par la digital PR, la couverture éditoriale, les plateformes d’avis, Reddit et les fils de discussion des communautés : ces lieux que vous ne possédez pas, où les modèles vérifient ce que les gens pensent vraiment.
La couche suivante : la recherche comme gestionnaire d’agents
Si vous élargissez la perspective, le changement dépasse largement les citations.
Les dirigeants de Google, Sundar Pichai et Demis Hassabis, décrivent une recherche qui passe d’un index de liens à un gestionnaire d’agents : quelque chose qui coordonne des tâches, exécute des workflows et finalise des transactions pour l’utilisateur.
Cela change tout. On ne parle plus de « l’utilisateur cherche → clique → achète ». On parle de « l’utilisateur exprime son intention et ses contraintes → l’agent compare, négocie et transige ».
Quatre couches à surveiller :
- Le Universal Cart de Google. Un paiement multi-détaillants dans Google Wallet, qui suit les stocks, les variations de prix et les promotions. La marche à suivre : traitez votre flux Merchant Center comme un produit, pas comme une corvée. Exactitude en temps réel, balisage de prix propre, rien d’obsolète.
- Universal Commerce Protocol (UCP). Un standard ouvert co-développé par Google et Shopify, qui permet aux agents de découvrir des produits, de les comparer et de passer à la caisse pendant que vous restez le marchand officiel. La marche à suivre : ajoutez des endpoints agentiques comme
/.well-known/ucpà vos audits techniques. - WebMCP. Expose les outils interactifs d’un site (calculateurs, outils de planification, aides au dépannage) directement aux agents, qui appellent vos fonctions au lieu de scraper votre texte. La marche à suivre : listez vos outils d’aide à la décision et rendez-les appelables.
- Lunettes connectées et recherche multimodale. La recherche quitte l’écran et entre dans la pièce. « Regarde cet appareil, diagnostique le bruit, commande la pièce. » La marche à suivre : reliez des scénarios réels problème → solution à des données structurées et à des ressources visuelles.
Et c’est là que la plupart des organisations vont trébucher. Le SEO technique, la gestion des flux, le développement et les relations presse sont généralement dans des pièces séparées. Dans un monde agentique, ils forment un seul pipeline. L’agent ne peut pas finaliser l’achat de votre produit si l’équipe de développement n’a pas exposé l’endpoint, si le flux affiche le mauvais prix, ou si les relations presse n’ont jamais construit la confiance qui vous a fait entrer dans la présélection.
Ce n’est plus un problème de canal. C’est un problème d’organigramme.
Qui doit réellement investir, et qui doit d’abord réparer la cave
Toutes les entreprises n’ont pas besoin de courir après ça dès maintenant.
Investissez dès maintenant si :
- Votre parcours d’achat est complexe et à forte réflexion : enseignement, logiciels B2B, finance, santé, équipement technique.
- Une mauvaise réponse de l’IA sur vos spécifications crée de vrais dommages opérationnels, financiers ou juridiques.
- Vos fondations SEO, l’architecture de votre site et le suivi des conversions fonctionnent déjà.
Réparez d’abord les fondations si :
- Vous avez encore des problèmes non résolus de SEO technique, d’indexation ou de mobile.
- Vous ne suivez pas les conversions. Dans le jeu de données de Haynes, 45 des 100 sites ne le faisaient pas, ce qui signifie qu’ils ne pouvaient même pas mesurer ce qu’ils veulent améliorer.
- Vous vendez des produits d’impulsion à faible réflexion que personne ne recherche via une IA.
La séquence
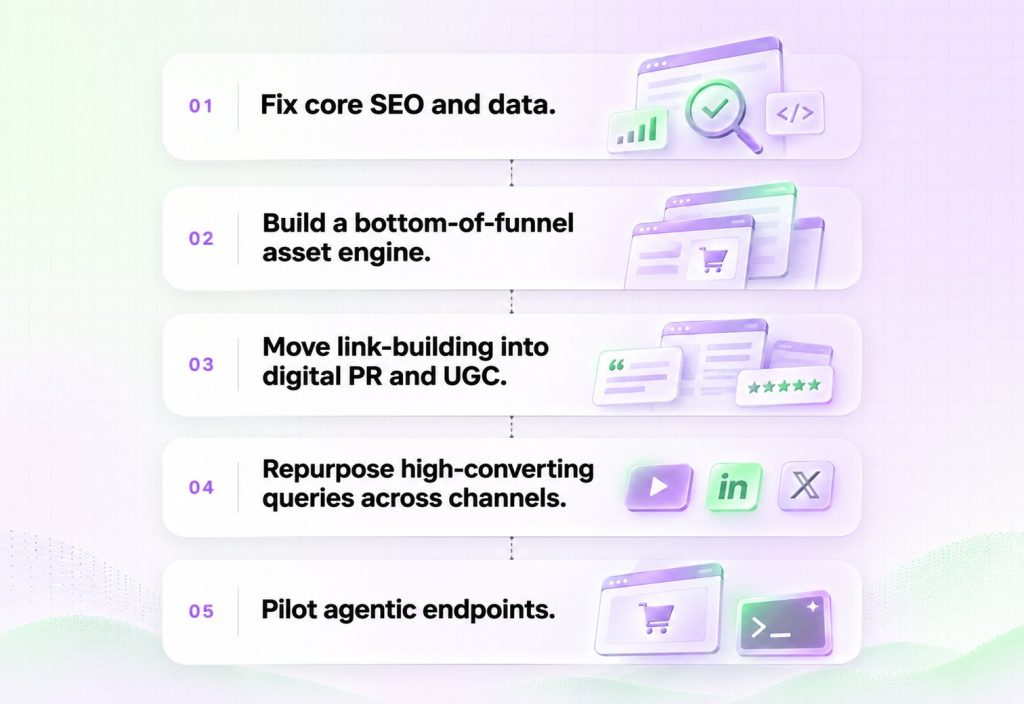
- Corrigez le SEO de base et les données. Erreurs d’exploration, schema des entités, conversions GA4. Sans mesure, tout ce qui suit relève de la devinette.
- Construisez un moteur de contenus de bas de funnel. Des landing pages et des fiches produit structurées. Ensemble, elles représentaient presque 30 % des citations dans les données de PromptWatch.
- Faites passer le netlinking vers la digital PR et l’UGC. Entrez dans les comparatifs de tiers, les articles éditoriaux et les plateformes d’avis. Soignez le sentiment réel là où les modèles le lisent.
- Réutilisez les requêtes à forte conversion sur d’autres canaux. Vidéo courte, LinkedIn, X. Pas pour le théâtre de la portée, mais pour construire une densité d’entité sur tout le web.
- Testez des endpoints agentiques en pilote. Menez de petites expériences trimestrielles : Merchant Center pour l’éligibilité au Universal Cart, WebMCP sur un outil interactif.
Alors, qu’est-ce qui change vraiment ?
Personne ne piège un LLM pour qu’il le recommande. Ni avec llms.txt, ni avec un « schema IA », ni avec un texte robotique découpé en morceaux.
Comparez la visibilité dans l’IA à un panneau publicitaire : c’est plus du branding que de la performance, et cela ne génère pas principalement du trafic.
Ce qui change, c’est la question que vous posez. Non pas « comment apparaître dans l’IA ? » mais « notre marque est-elle assez vraie, assez trouvable et assez digne de confiance pour que n’importe quel système, humain ou machine, nous choisisse pour la bonne personne et nous écarte pour la mauvaise ? »
Ce n’est pas une nouvelle discipline. C’est du SEO, enfin mesuré par le bon résultat. Simplement, nous l’appelons GEO.
Sources
- ChatGPT sends less than 1 % of Google’s traffic (Search Engine Land)
- ChatGPT sends less than 1 % of Google’s traffic (MarTech)
- Haynes study coverage, incl. 45/100 sites not tracking conversions (info-lux)
- Universal Commerce Protocol (Shopify)
- Self-Promotional Content Works, Until It Backfires (Ahrefs)
Gregory décortique les SERP et les données de Search Console pour les clients d’InSpace, et partage ce qui fait vraiment la différence.