Google’s SAFE: het forensische slop-systeem dat niet op YouTube blijft
Het SAFE-paper van Google leest als een YouTube-verhaal. Dat is het niet. Het beoordeelt de operatie, niet de upload, en webcontent is de logische volgende stap.
- SAFE is een systeem van Google met vier agents dat netwerken van AI-content onderzoekt, geen losse stukken.
- Twee van de drie specialisten lezen de content nooit. Ze kijken naar timing, infrastructuur en relaties.
- Het paper gaat over YouTube en noemt Search nergens, maar elk signaal dat het gebruikt heeft een tegenhanger op het web.
- Het risico is niet AI. Het is eenvormigheid op schaal: publiceer wat alleen uw bedrijf had kunnen publiceren.
De verkeerde vraag
Bij elke spamupdate komt dezelfde vraag terug. Kan Google AI-tekst herkennen? De spamupdate van september 2026 loopt sinds 24 september, en daar is hij weer. Elk SEO-kanaal, elke thread.
Ik denk niet dat dat nog de echte vraag is. En dat zeg ik door een Google-paper van drie pagina’s dat de meeste mensen lezen als een YouTube-verhaal.
Het heet SAFE, de Scaled Abuse Forensics Examiner. Het vraagt niet “is dit door AI gemaakt?” Het vraagt “hoort dit bij een operatie?”
Dat verandert het hele kader. Want zodra u ziet waarvoor het gebouwd is, kunt u niet meer wegkijken van waar het hierna heen gaat.
Wat SAFE eigenlijk is
Dus eerst de feiten. SAFE is een multi-agent-systeem dat vermoedelijke netwerken van AI-content onderzoekt zoals een menselijke forensisch analist dat zou doen. Het staat beschreven in een paper van Google Research met de titel The Synthetic Gap: Automating Forensic Investigation of “AI Slop” with the Scaled Abuse Forensics Examiner (SAFE).
- Auteurs: zeven medewerkers van Google, uit Trust & Safety en engineering.
- Datum: volgens de metadata van de pdf 28 mei 2026. Het dook op 25 september op in SEO-media, een dag nadat de spamupdate begon.
- Lengte: drie pagina’s, inclusief bronnen.
Het probleem dat het benoemt, noemen de auteurs de “synthetic gap”: de tijd tussen het opduiken van een nieuwe generatieve aanval en het moment dat Google er een antwoord op heeft. En het punt is: misbruiknetwerken kopiëren en plakken niet meer. Ze maken unieke, gelokaliseerde varianten van hetzelfde materiaal. Niets is dubbel genoeg om te clusteren, dus klassieke detectie mist het gewoon.
Maar de mensen erachter gedragen zich nog steeds hetzelfde. Daar draait het om. Niet de content, maar het gedrag erachter. En SAFE geeft geen kansscore zoals een klassieke classifier. Het redeneert over bewijs, zoals een onderzoeker dat doet.
Hoe het werkt: vier agents, één oordeel
Wat interessant is, is hoe het gebouwd is. Niet één model, maar een klein forensisch team: één leider, drie specialisten, één oordeel over het hele cluster.
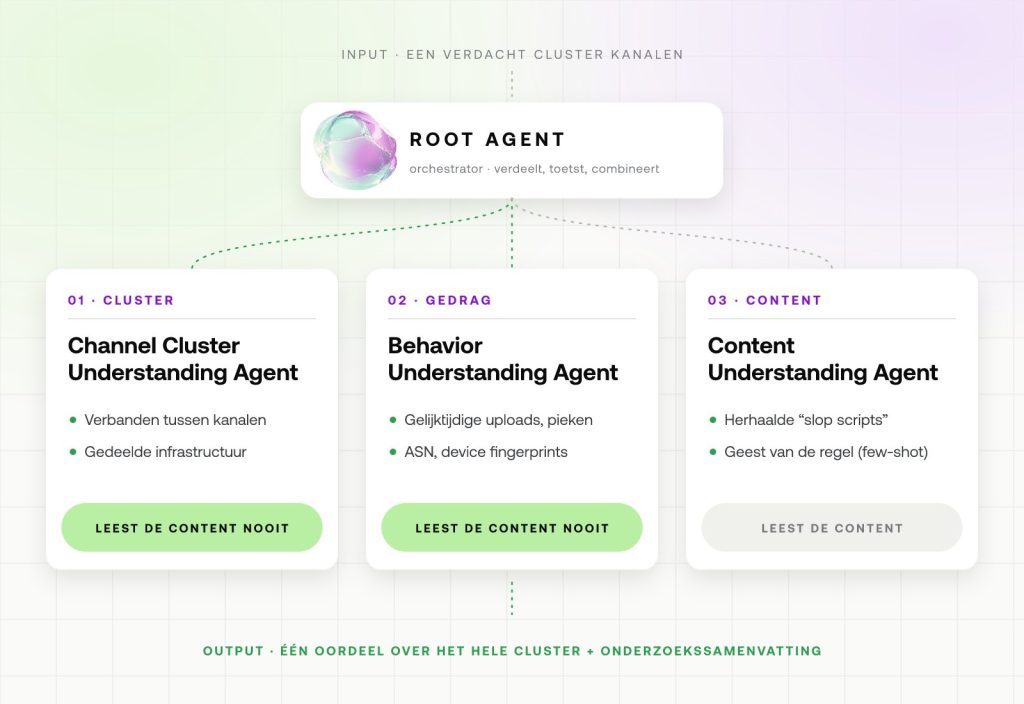
Kijk daar nog eens naar. De content-agent is er één van de drie. Twee van de drie specialisten lezen de content helemaal niet. Ze kijken naar timing, infrastructuur en relaties. En dat is precies de laag waar herschrijven met AI niets kan verbergen. U kunt elke zin herschrijven. Een publicatiepatroon herschrijven lukt niet.
Wat het paper niet zegt
Voordat ik verder ga, de feiten. Want een deel van de berichtgeving loopt voor het document uit, en daar begint dit debat mis te gaan.
- Het gaat over YouTube. De databronnen in het paper zijn YouTube-kanaalsignalen, kanaalverbindingen en videometadata. De nauwkeurigheid wordt gemeten op sets van kanaal-ID’s.
- Google Search wordt nergens genoemd. Geen websites, geen rankings, geen SpamBrain, geen spamupdates.
- “In gebruik” hangt aan één zin. De samenvatting noemt vroege resultaten uit de praktijk. Het evaluatiedeel noemt de metrics die Google gaat gebruiken, zonder cijfers.
- Het versnelt mensen in plaats van ze te vervangen. Elke metric wordt afgezet tegen menselijke analisten. SAFE levert een oordeel en een onderzoekssamenvatting.
- Google heeft SAFE niet gekoppeld aan de update van september. Google noemde geen doelwit, geen aandeel van de getroffen zoekopdrachten en geen nieuw beleid voor deze uitrol.
Dus wie u vertelt dat SAFE nu al binnen de spamupdate van september draait, gokt. Die claim maak ik niet. Mijn claim gaat over de richting. En die richting is voor mij geen gok.
Waarom webcontent de logische volgende stap is
Dus dit is ons standpunt, en het staat. SAFE is een eerste inzet. Webcontent is de volgende stap. Google heeft dat niet gezegd, en dat hoeft ook niet. De manier waarop Google zijn systemen bouwt en hergebruikt, zegt het voor ze.
Op het eerste gezicht lijkt dit een videoprobleem. Dat is het niet. Het is een coördinatieprobleem. En coördinatie trekt zich niets aan van het formaat.
1. Elk signaal dat SAFE gebruikt, heeft een tegenhanger op het web
De vertaling hieronder is onze lezing, niet die van Google. Maar kijk er goed naar: niets ervan vraagt om een nieuw soort data.
| Waar SAFE op YouTube naar kijkt | De waarschijnlijke tegenhanger op het web |
|---|---|
| Een kanaal | Een domein, subdomein of auteursprofiel |
| Gelijktijdige uploads, publiceren in pieken | Pieken in publicatiedata, sitemap- en lastmod-pieken |
| Infrastructuur: ASN, device fingerprints | Hosting, IP-reeksen, CMS- en tag-fingerprints |
| Relaties tussen kanalen | Linkgraaf, onderlinge links, gedeeld eigenaarschap |
| Herhaalde “slop scripts” | Artikelen uit één sjabloon, hergebruikte prompt-opbouw |
2. Tekst is makkelijker te lezen dan video. Niet moeilijker
Bij video moet het script eerst uit audio en beelden worden gehaald. Op het web is de pagina het script. Opbouw, formulering, sjabloon: het ligt er allemaal klaar voor een LLM om over domeinen heen te vergelijken.
3. Het beleid is al geschreven
Scaled content abuse dekt al massaal geproduceerde pagina’s die vooral gemaakt zijn om rankings te manipuleren, en noemt generatieve AI als een van de mogelijke middelen. Op 15 mei 2026 breidde Google zijn spambeleid uit naar AI Overviews en AI Mode. Er is dus geen nieuwe regel nodig. Alleen een betere detector.
4. Het “geest van de regel”-model past precies op dat beleid
Scaled content abuse wordt gedefinieerd door intentie, niet door een patroon. En dat is precies waarvoor het few-shot-onderdeel van SAFE gebouwd is: overtredingen die de vaste regels ontwijken, maar toch ingaan tegen waar de regel voor bedoeld is.
5. Denken in netwerken zit al in Search
Een voormalig lid van het search-quality-team van Google beschreef in april hoe spambestrijders op grote schaal netwerken herkenden aan hun vingerafdruk en onduidelijke gevallen doorstuurden naar handmatige controle. SAFE is die werkwijze. Geautomatiseerd.
6. Zo bouwt Google nu eenmaal
Google ontwikkelt detectie waar de data en de druk het grootst zijn, en neemt de aanpak daarna mee naar zijn andere producten. Volgens het Ads Safety Report 2025 gebruikt de handhaving van advertenties al modellen op basis van Gemini om de intentie achter een advertentie te beoordelen, in plaats van patronen te matchen. In mei werden de spamregels van Search uitgerekt naar AI Overviews en AI Mode. Dezelfde regels, meer oppervlakken. Dat SAFE eerst op YouTube gebouwd is, maakt het dus geen YouTube-tool. Het maakt YouTube de eerste klant.
En als u het iets breder trekt, is er in hetzelfde jaar een precedent. Google’s eerdere systeem, S-CTS, beëindigt naar verluidt een heel cluster als een groot deel van de accounts dezelfde AI-sjablonen gebruikt. Twee papers, één doctrine: beoordeel de operatie, niet de upload.
De vraag is dus niet óf dit webcontent bereikt. De vraag is hoe hard Google het zegt als het zover is.
Wat dit betekent voor gepubliceerde content
Hier kijken de meeste mensen naar het verkeerde. Ze checken of één artikel leest als AI. Maar de eenheid van risico verschuift. Niet de pagina, maar de operatie. Eén artikel dat met hulp van AI is geschreven, op een echte merksite, is niet waarvoor dit soort systemen gebouwd is. Een patroon over veel sites wel.
Dus wie loopt er echt risico?
- Het meeste risico: leadgen- en affiliatenetwerken die veel domeinen draaien vanuit één sjabloon, één host en één publicatieschema.
- Risico: programmatische paginasets waarin alleen de stad, het product of het zoekwoord verandert, en al het andere hetzelfde sjabloon is.
- De grijze zone: bureaus en platforms die voor veel klanten content met hulp van AI publiceren via gedeelde tooling. Gedeelde tooling is geen manipulatie. Maar een oordeel op clusterniveau kan moeite hebben om dat verschil te zien, en het paper zegt niets over valse positieven of bezwaar.
- Het minste risico: losse merken die content publiceren met echte ervaring, echte bronnen en een eigen opbouw, met of zonder hulp van AI.
Over die grijze zone mag onze branche eerlijker zijn. En ja, dat geldt ook voor bureaus zoals wij. Dezelfde efficiëntie die publiceren met AI aantrekkelijk maakt, zorgt er ook voor dat de output op elkaar gaat lijken. En gelijkvormigheid is precies wat SAFE moet opvallen.
Het verklaart ook iets wat mensen uit de praktijk melden over de uitrol van september: pagina’s onderin de funnel blijven stabiel, informatieve blogcontent beweegt nog (Edward Sturm, aflevering 1.180). Dat klinkt als een funnelverhaal. Ik denk niet dat het dat is. De funnelfase is niet de bescherming. Hoe specifiek de content voor het bedrijf is, wel. Een dienstpagina met echte prijzen en aanbiedingen is niet zomaar naar een concurrent te verplaatsen. Een algemeen how-to-artikel wel, in seconden.
Het probleem is dus niet AI. Het is eenvormigheid op schaal.
Wat u nu doet
Twee routes. Welke past, hangt af van hoeveel van uw content op schaal wordt gemaakt.
De gedurfde zet: zoek de vingerafdruk voordat Google dat doet
Kijk naar uw content zoals SAFE naar een cluster kanalen kijkt:
- Opbouw: delen pagina’s op uw sites, of op de sites van uw klanten, hetzelfde skelet, dezelfde volgorde van secties en dezelfde formuleringen?
- Gedrag: wordt er in pieken gepubliceerd, volgens een vast schema dat op alle domeinen gelijk is?
- Infrastructuur: delen die sites hosting, tag-ID’s, CMS-inrichting en signalen van eigenaarschap?
- Relaties: linken ze naar elkaar op een manier die een lezer nooit nodig zou hebben?
Bouw daarna variatie en redactioneel oordeel in de pipeline zelf in: een menselijke laag, echte bronnen, echte ervaring, een opbouw die per onderwerp gekozen wordt. Niet als versiering. Als bewijs dat er een uitgever achter de pagina’s zit.
En dan één test die laat zien of het gewerkt heeft: de merkwisseltest. Neem een artikel. Haal de merknaam weg. Zet het op de site van een concurrent. Klopt het nog steeds? Dan is het vervangbaar, en vervangbare content op schaal is precies het patroon waar deze systemen op jagen. Het slaagt pas als het iets draagt wat de concurrent niet kan hebben: eigen data, cases, prijzen, mensen, lokale context, meningen die het bedrijf echt zou verdedigen.
De race is dus niet om content onvindbaar te maken. Die race verliest u, want detectie ontwijken is precies het gedrag dat SAFE moet zien. De race is om content te maken die alleen dat bedrijf had kunnen publiceren.
Het voorzichtige alternatief: niet reageren midden in de uitrol
De update van september kan doorlopen tot ongeveer 8 oktober. Leg veranderingen in rankings en verkeer naast de data van de uitrol. Toets getroffen pagina’s aan het bestaande spambeleid. En wacht op het bericht van Google dat de uitrol klaar is, voordat u iets structureels verandert.
Beide routes beginnen natuurlijk op dezelfde plek: weten hoe uw content er van buitenaf uitziet.
De echte verschuiving
Twee jaar lang vroeg de SEO-branche of een pagina leest als AI. SAFE laat zien dat Google iets heel anders vraagt. Hoort deze pagina bij een operatie?
Dat is de echte verschuiving. Daar prompt u uzelf niet uit, want het bewijs zit niet in de zin. Het zit in de timing, de infrastructuur, het sjabloon, de links tussen sites.
De pagina is dus het symptoom. Het netwerk is het bewijs. Publiceer alsof er een uitgever achter zit. Want binnenkort is dat precies wat er gecontroleerd wordt.
Bronnen
- Google Research: SAFE publication page
- Google Research: SAFE paper (PDF)
- Search Engine Journal: Google Has Deployed A New AI Spam Detector Called SAFE
- PPC Land: Google’s SAFE uses 4 AI agents to investigate YouTube slop networks
- Search Engine Journal: Google Rolls Out September 2026 Spam Update Globally
- PPC Land: Sites breaking Google spam rules face lower rankings in two-week window
- PPC Land: Google spam policies now cover AI Overviews and AI Mode
- PPC Land: What Google actually looks for when it catches spam sites
- PPC Land: Google’s 2025 Ads Safety Report
- Edward Sturm podcast, episode 1,180 (YouTube)
Gregory spit voor InSpace-klanten door SERP’s en Search Console-data, en deelt wat echt verschil maakt.