SAFE de Google : le système d’enquête anti-slop qui ne restera pas sur YouTube
Le papier SAFE de Google se lit comme une histoire YouTube. Ce n’en est pas une. Il juge l’opération, pas la mise en ligne, et le contenu web est l’étape logique suivante.
- SAFE est un système Google à quatre agents qui enquête sur des réseaux de contenu généré par IA, pas sur des pièces isolées.
- Deux de ses trois spécialistes ne lisent jamais le contenu. Ils regardent le timing, l’infrastructure et les relations.
- Le papier porte sur YouTube et ne mentionne jamais Search, mais chaque signal utilisé a un équivalent sur le web.
- Le risque n’est pas l’IA. C’est l’uniformité à grande échelle : publiez ce que seule votre entreprise pouvait publier.
La mauvaise question
À chaque mise à jour anti-spam, la même question revient. Google sait-il détecter un texte écrit par l’IA ? La mise à jour anti-spam de septembre 2026 est en cours depuis le 24 septembre, et la revoilà. Sur chaque chaîne SEO, dans chaque fil de discussion.
Je ne pense pas que ce soit encore la vraie question. Et ce qui me fait dire cela, c’est un papier de Google de trois pages que la plupart des gens lisent comme une histoire YouTube.
Il s’appelle SAFE, le Scaled Abuse Forensics Examiner. Il ne demande pas « est-ce que c’est fait par l’IA ? » Il demande « est-ce que cela fait partie d’une opération ? »
Cela change tout le cadre. Car une fois qu’on a vu pourquoi il est conçu, il est difficile de ne pas voir où il ira ensuite.
Ce qu’est vraiment SAFE
D’abord les faits. SAFE est un système multi-agents qui enquête sur des réseaux présumés de contenu généré par IA, comme le ferait un analyste forensique humain. Il est décrit dans un papier de Google Research intitulé The Synthetic Gap: Automating Forensic Investigation of “AI Slop” with the Scaled Abuse Forensics Examiner (SAFE).
- Auteurs : sept employés de Google, issus de Trust & Safety et de l’ingénierie.
- Date : selon les métadonnées du PDF, le 28 mai 2026. Il est apparu dans les médias SEO le 25 septembre, un jour après le début de la mise à jour anti-spam.
- Longueur : trois pages, références comprises.
Le problème qu’il nomme, les auteurs l’appellent le « synthetic gap » : le temps entre l’apparition d’une nouvelle attaque générative et le moment où Google a une réponse. Et le fait est que les réseaux d’abus ne font plus de copier-coller. Ils produisent des variantes uniques et localisées du même matériau. Rien n’est assez identique pour être regroupé, donc la détection classique passe tout simplement à côté.
Mais les opérateurs se comportent toujours de la même manière. C’est tout l’enjeu. Pas le contenu, mais le comportement derrière. Et SAFE ne produit pas un score de probabilité comme un classifieur classique. Il raisonne sur des preuves, comme le ferait un enquêteur.
Comment il fonctionne : quatre agents, un verdict
Ce qui est intéressant, c’est sa construction. Pas un modèle, mais une petite équipe forensique : un responsable, trois spécialistes, un verdict sur l’ensemble du cluster.
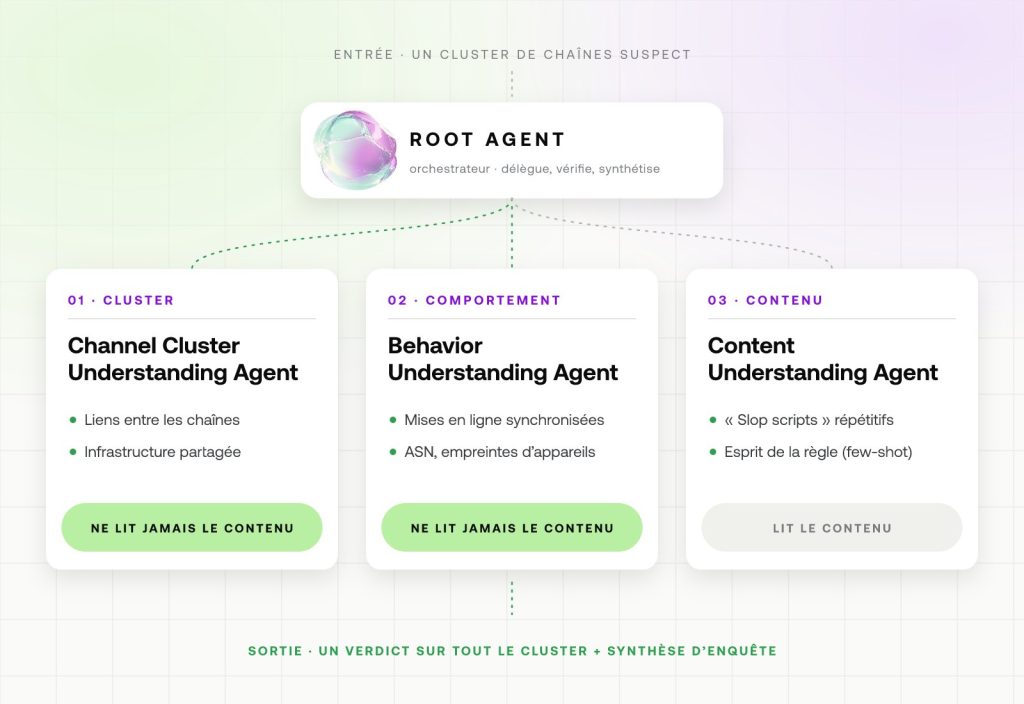
Regardez encore. L’agent contenu est un des trois. Deux des trois spécialistes ne lisent jamais le contenu. Ils regardent le timing, l’infrastructure et les relations. Et c’est exactement la couche où la réécriture par IA ne peut rien cacher. Vous pouvez réécrire chaque phrase. Vous ne pouvez pas réécrire un schéma de publication.
Ce que le papier ne dit pas
Avant d’aller plus loin, les faits. Car une partie de la couverture est allée plus vite que le document, et c’est là que ce débat commence à déraper.
- Il porte sur YouTube. Les sources de données du papier sont des signaux de chaînes YouTube, des connexions entre chaînes et des métadonnées vidéo. La précision est mesurée sur des ensembles d’identifiants de chaînes.
- Il ne mentionne jamais Google Search. Pas de sites web, pas de classements, pas de SpamBrain, pas de mises à jour anti-spam.
- « Déployé » repose sur une seule phrase. Le résumé évoque des premiers résultats de déploiement. La partie évaluation liste les métriques que Google utilisera, sans chiffres.
- Il accélère les humains au lieu de les remplacer. Chaque métrique est comparée à des analystes humains. SAFE produit un verdict et une synthèse d’enquête.
- Google n’a pas relié SAFE à la mise à jour de septembre. Google n’a nommé ni cible, ni part de requêtes touchées, ni nouvelle règle pour ce déploiement.
Donc quiconque vous dit que SAFE tourne en ce moment dans la mise à jour anti-spam de septembre devine. Je ne fais pas cette affirmation. Mon affirmation porte sur la direction. Et pour moi, la direction n’est pas une supposition.
Pourquoi le contenu web est l’étape logique suivante
Voici donc notre position, et elle est ferme. SAFE est un premier déploiement. Le contenu web est l’étape suivante. Google ne l’a pas dit, et n’a pas besoin de le dire. La façon dont Google construit et réutilise ses systèmes le dit à sa place.
Au premier abord, cela ressemble à un problème de vidéo. Ce n’en est pas un. C’est un problème de coordination. Et la coordination se moque du format.
1. Chaque signal utilisé par SAFE a un équivalent sur le web
La correspondance ci-dessous est notre lecture, pas celle de Google. Mais regardez-la bien : rien de tout cela ne demande un nouveau type de données.
| Ce que SAFE regarde sur YouTube | L’équivalent probable sur le web |
|---|---|
| Une chaîne | Un domaine, un sous-domaine ou un profil d’auteur |
| Mises en ligne synchronisées, publication en rafales | Rafales de dates de publication, pics de sitemap et de lastmod |
| Infrastructure : ASN, empreintes d’appareils | Hébergement, plages d’IP, empreintes de CMS et de tags |
| Relations entre chaînes | Graphe de liens, liens croisés, propriété partagée |
| « Slop scripts » répétitifs | Structures d’articles sur modèle, trames de prompts réutilisées |
2. Le texte est plus facile à lire que la vidéo. Pas plus difficile
En vidéo, le script doit d’abord être extrait de l’audio et des images. Sur le web, le script, c’est la page. Structure, formulation, trame : tout est là pour qu’un LLM compare d’un domaine à l’autre.
3. La règle est déjà écrite
Le scaled content abuse couvre déjà les pages produites en masse principalement pour manipuler les classements, et cite l’IA générative comme un moyen possible. Le 15 mai 2026, Google a étendu ses règles anti-spam aux AI Overviews et à l’AI Mode. Aucune nouvelle règle n’est donc nécessaire. Juste un meilleur détecteur.
4. Le modèle de « l’esprit de la règle » correspond exactement à cette règle
Le scaled content abuse se définit par l’intention, pas par un schéma. Et c’est précisément ce pour quoi le composant few-shot de SAFE est conçu : des infractions qui contournent les règles fixes mais trahissent quand même ce à quoi la règle sert.
5. La pensée en réseaux existe déjà dans Search
Un ancien membre de l’équipe search quality de Google a décrit en avril comment les équipes anti-spam identifiaient des réseaux à grande échelle par leur empreinte et envoyaient les cas incertains en revue manuelle. SAFE, c’est ce processus. Automatisé.
6. C’est simplement ainsi que Google construit
Google développe la détection là où les données et la pression sont les plus fortes, puis transpose l’approche à ses autres produits. Selon son Ads Safety Report 2025, le contrôle des annonces utilise déjà des modèles basés sur Gemini pour juger l’intention derrière une annonce au lieu de faire correspondre des schémas. En mai, ses règles anti-spam de recherche ont été étendues aux AI Overviews et à l’AI Mode. Les mêmes règles, plus de surfaces. Construire SAFE d’abord sur YouTube n’en fait donc pas un outil YouTube. Cela fait de YouTube le premier client.
Et si l’on élargit un peu, il existe un précédent la même année. Le système antérieur de Google, S-CTS, mettrait fin à un cluster entier lorsqu’une forte proportion de ses comptes utilise les mêmes modèles générés par IA. Deux papiers, une doctrine : juger l’opération, pas la mise en ligne.
La question n’est donc pas de savoir si cela atteindra le contenu web. C’est de savoir avec quelle force Google le dira le moment venu.
Ce que cela signifie pour le contenu publié
C’est ici que la plupart des gens regardent au mauvais endroit. Ils vérifient si un article isolé ressemble à de l’IA. Mais l’unité de risque se déplace. Pas la page, mais l’opération. Un article isolé rédigé avec l’aide de l’IA sur un vrai site de marque n’est pas ce que ce type de système est conçu pour attraper. Un schéma répété sur de nombreux sites, si.
Alors, qui est vraiment exposé ?
- Les plus exposés : les réseaux de génération de leads et d’affiliation qui gèrent de nombreux domaines à partir d’un modèle, d’un hébergeur et d’un calendrier de publication.
- Exposés : les ensembles de pages programmatiques où seuls la ville, le produit ou le mot-clé changent, et où tout le reste suit la même trame.
- La zone grise : les agences et plateformes qui publient du contenu assisté par IA pour de nombreux clients avec des outils partagés. Des outils partagés ne sont pas de la manipulation. Mais un verdict au niveau du cluster pourrait avoir du mal à faire cette différence, et le papier ne dit rien des faux positifs ni des recours.
- Les moins exposés : les marques individuelles qui publient du contenu avec une vraie expérience, de vraies sources et leur propre structure, avec ou sans IA.
Sur cette zone grise, notre secteur devrait être plus honnête. Et oui, cela inclut des agences comme la nôtre. La même efficacité qui rend la publication par IA attrayante rend aussi les résultats semblables. Et la ressemblance est exactement ce que SAFE est conçu pour remarquer.
Cela explique aussi ce que des praticiens rapportent du déploiement de septembre : les pages de bas de funnel tiennent, le contenu de blog informatif continue de bouger (Edward Sturm, épisode 1 180). Cela ressemble à une histoire de funnel. Je ne crois pas que ce soit le cas. Ce n’est pas l’étape du funnel qui protège. C’est la spécificité de l’entreprise. Une page de service avec de vrais prix et de vraies offres est difficile à transposer chez un concurrent. Un article how-to générique se transpose en quelques secondes.
Le problème n’est donc pas l’IA. C’est l’uniformité à grande échelle.
Que faire maintenant
Deux voies. Laquelle convient dépend de la part de votre contenu produite à grande échelle.
L’option audacieuse : cherchez l’empreinte avant Google
Regardez votre contenu comme SAFE regarde un cluster de chaînes :
- Structure : les pages de vos sites, ou de ceux de vos clients, partagent-elles le même squelette, le même ordre de sections et les mêmes formulations ?
- Comportement : la publication se fait-elle en rafales selon un calendrier fixe, identique d’un domaine à l’autre ?
- Infrastructure : ces sites partagent-ils hébergement, identifiants de tags, configuration de CMS et signaux de propriété ?
- Relations : se lient-ils entre eux d’une manière dont un lecteur n’aurait jamais besoin ?
Intégrez ensuite de la variété et du jugement éditorial dans le processus lui-même : une couche humaine, de vraies sources, une vraie expérience, une structure choisie par sujet. Pas comme décoration. Comme preuve qu’il y a un éditeur derrière les pages.
Puis un test qui vous dit si cela a fonctionné : le test d’échange de marque. Prenez un article. Retirez le nom de la marque. Placez-le sur le site d’un concurrent. Tient-il toujours ? Alors il est remplaçable, et le contenu remplaçable à grande échelle est exactement le schéma que traquent ces systèmes. Il ne passe le test que s’il porte ce que le concurrent ne peut pas avoir : ses propres données, cas clients, prix, personnes, contexte local, opinions qu’il défendrait vraiment.
La course ne consiste donc pas à rendre le contenu indétectable. C’est une course perdue d’avance, car échapper à la détection est exactement le comportement que SAFE doit repérer. La course consiste à créer du contenu que seule cette entreprise aurait pu publier.
Le repli prudent : ne pas réagir en plein déploiement
La mise à jour de septembre peut se poursuivre jusqu’au 8 octobre environ. Notez les variations de classement et de trafic en regard des dates de déploiement. Vérifiez les pages touchées au regard des règles anti-spam existantes. Et attendez l’annonce de fin de Google avant de changer quoi que ce soit de structurel.
Les deux voies partent bien sûr du même point : savoir à quoi ressemble votre contenu vu de l’extérieur.
Le vrai changement
Pendant deux ans, le secteur SEO s’est demandé si une page ressemblait à de l’IA. SAFE montre que Google pose une tout autre question. Cette page fait-elle partie d’une opération ?
C’est cela, le vrai changement. Aucun prompt ne vous en sortira, car la preuve n’est pas dans la phrase. Elle est dans le timing, l’infrastructure, le modèle, les liens entre les sites.
La page est donc le symptôme. Le réseau est la preuve. Publiez comme s’il y avait un éditeur derrière. Car bientôt, c’est exactement ce qui sera vérifié.
Sources
- Google Research: SAFE publication page
- Google Research: SAFE paper (PDF)
- Search Engine Journal: Google Has Deployed A New AI Spam Detector Called SAFE
- PPC Land: Google’s SAFE uses 4 AI agents to investigate YouTube slop networks
- Search Engine Journal: Google Rolls Out September 2026 Spam Update Globally
- PPC Land: Sites breaking Google spam rules face lower rankings in two-week window
- PPC Land: Google spam policies now cover AI Overviews and AI Mode
- PPC Land: What Google actually looks for when it catches spam sites
- PPC Land: Google’s 2025 Ads Safety Report
- Edward Sturm podcast, episode 1 180 (YouTube)
Gregory décortique les SERP et les données de Search Console pour les clients d'InSpace, et partage ce qui fait vraiment la différence.